buro: типизированная память
озвучечка14:33
buro
Публикую свою систему памяти для нейросетей, которой пользуюсь уже около 5 месяцев. при проектировании и создании данного инструмента передо мной стояла следующая задача: нейросеть должна помнить о моих проектах и иных рабочих сущностях МЕЖДУ сессиями, причем самостоятельно вести эту память без моего вмешательства.
buro — это кастрированная bureaucracy, в которой сохранился принцип bureau, т.е. места, куда складывают всё необходимое, где у каждой вещи есть своё место, а у самого хранения имеется определённая структура и правила организации. Но не сохранился принцип -cracy (κράτος), потому что сама власть здесь принадлежит ИИ-агенту. Моя задача — сделать так, чтобы эта власть была предсказуемой, а бюро исправно выполняло свою работу и было понятным и простым для его пользователя.
Вся логика строится вокруг концепции типизированной памяти. Мной это классифицируется как ПОЛНАЯ замена [гигантских] AGENTS.md, RAG, боже упаси хранения всего в skills, обслуживания llm wiki и прочего, что нужно дополнительно поддерживать и/или постоянно (ре)организовывать, создавая ситуацию второй работы. По крайней мере в такой ситуации нельзя быть уверенным в стабильном, надежном и предсказуемом решении, потому что "передовые" публичные технологии памяти для ИИ постоянно модифицируются и/или улучшаются, что создает ситуацию догонялок, а точнее зависимости от обновлений и новых "революционных" решений. Меня в свою очередь интересует, чтобы система памяти о проектах/сервисах/хостах/etc была организована с помощью такой технологии, которая переживет и будет служить дольше наличных передовых решений и их актуальных версий.
За 5 месяцев с момента создания инструмента мне ни разу не приходилось тратить время на его особо глубокое или вдумчивое обслуживание, благодаря чему надежная память между сессиями стала для меня чем-то само собой разумеющимся. конечно же, перед публичным релизом как всегда и бывает пришлось потратить некоторое время чтобы довести до ума все внутренние механизмы ради достижения универсальности и удобства для всех возможных пользователей.
если совсем сжато:
1/ бюро предоставляет нейросети единый реестр рабочих сущностей: проектов, сервисов, компьютеров и других конкретных объектов пользователя.
2/ каждая запись хранит сведения о своём объекте: его назначение, расположения, связи, принятые решения, правила и ограничения. эти сведения сохраняются между сессиями и доступны независимо от того, в каком проекте работает агент.
3/ система buro связывает реестр с нейросетью и её харнессом: даёт CLI (интерфейс командной строки), локальную или межхостовую память и проверяемый способ её изменения. через CLI агент управляет бюро командами в терминале.
4/ записи ведёт агент (юзеру конечно не запрещено, но очевидно это что-то из разряда экзотического). всё устроено так, чтобы юзер мог заниматься своими делами и работать, в то время как нейросеть выполняет работу по сохранению и обновлению полезной памяти.
как всё работает
В бюро мы создаём отдельные записи о конкретных сущностях и разделяем сведения о них по заранее определённым полям-категориям-типам-классам.
например, у меня есть проект сайта. у него есть назначение, расположение исходников, рабочая версия на сервере, определённые правила разработки, принятые решения, запреты и проч. всё это можно хранить в одной записи с несколькими полями:
.summary: что это за проект и зачем он существует;
.important: важные факты, принятые решения, требования и условия согласования;
.avoid: то, чего при работе делать НЕ следует;
.locations: где лежат исходники, где находится рабочая версия, на каком сервере всё работает;
.related: связанные сущности, документы, ссылки;
.read_first: что нужно прочитать перед работой;
.notes: дополнительные устойчивые сведения, которые не вписываются в краткий summary.
из коробки доступны три типа сущностей: project, service, host. первый для самостоятельных проектов и продуктов, второй для технических компонентов рабочего окружения, третий для компьютеров, серверов и подобной электроники. Этого мне для своей инфраструктуры в основном хватает, НО никто не мешает создать собственный тип, например lab, research etc.
для проектной памяти buro полностью заменяет мне агентс.мд и раг, от которых меня блевать тянет, потому что это максимально бесполезные и невыносимо плохие платформы для хранения памяти о проекте и его отношений с юзером. В случае бюро память существует независимо от расположения проектов в геометрии папок, может использоваться с разных устройств и не требует поддерживать несколько копий одних и тех же сведений - это умные дядьки называли централизацией и унификацией.
логика pre-, intra- и post-
1. pre-.
проблема: нейросеть должна заранее знать о существовании buro, о том, как получать сведения, когда их использовать и чему железно доверять.
решение: Так или иначе вся система сводится к тексту, его классам и категориям. поэтому одна из первоначальных задач для меня была в том, чтобы нейросеть на автоматическом уровне воспринимала бюро как важный источник, которому стоит доверять и всегда держать в тонусе. решил я это с помощью кастомного блока в системном промпте, который создает систему доверия, обновлений после работы, а также описывает самую важную инфу об инструменте и наличной конфигурации.
Благодаря тому, что системный промпт имеет высокий приоритет в иерархии инструкций и передаётся модели при каждом обращении, такая система действует безотказно. следовательно, туда можно один раз добавить небольшой блок по бюро, после чего нейросеть будет by default знать, что у неё есть внешняя память, как с ней работать и что в конце выполненной работы её нужно при необходимости актуализировать.
Кроме того, существует skill, который объясняет нейросети весь порядок работы с памятью. В своей экосистеме я использую его вместе с кастомным блоком системного промпта для полной надежности, чтобы агент никогда не забывал о бюро и о том, как им пользоваться. Для других харнессов, где нельзя редактировать системный промпт, альтернативой можно назвать использование только скилла, но мне трудно сказать насколько надежно это будет работать, потому что такое мной не тестировалось. тем не менее кажется, что надежность вряд ли сильно упадет.
тут особое внимание можно уделить моему opencodez (форк опенкода с некоторыми улучшениями), в котором через настройки можно модифицировать/создавать системные промпты для любых моделей или семейств.
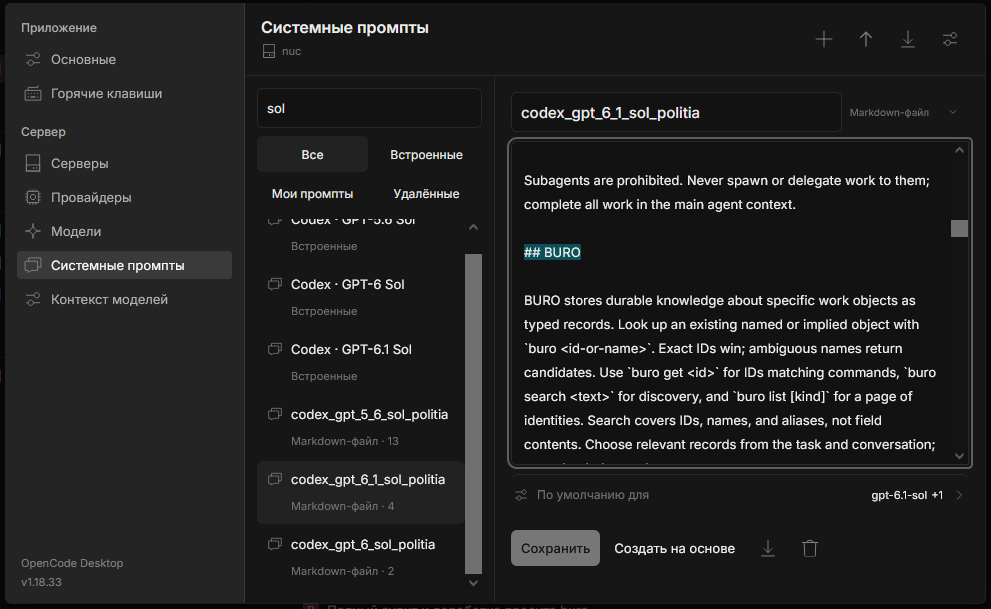
сам кастомный блок системного промпта находится тут — его только и остаётся, что скопировать в настройки opencodez.
И ещё одна важная для удобства штука — плагин, который автоматически запускает buro current в начале каждой новой сессии. благодаря этому нейросеть сразу получает все конкретные сведения о текущем хосте и список сущностей, которые на нём находятся. расход токенов околонулевой.
это позволяет нейронке ещё до начала выполнения работы понимать, на каком устройстве она работает и с какими объектами здесь вообще будет иметься дело. полные записи она уже самостоятельно запрашивает по необходимости.
СОСТАВЛЯЮЩИЕ pre-процессинга: Установленный buro; Кастомный блок в системном промпте; Skill; Плагин в самом харнессе для удобства агента.
2. intra-. непосредственно работа с памятью.
здесь всё предельно просто: агент через терминал обращается к buro, получает нужную запись и учитывает её содержимое во время работы. например, если я говорю продолжить разработку определённого проекта, нейросеть может открыть его запись и получить все существенные сведения, решения и ограничения, которые были сохранены при работе в предыдущих сессиях.
3. postprocessing. актуализация памяти после выполненной работы.
По умолчанию агент должен самостоятельно определить, появились ли за сессию какие-то полезные сведения, новые решения, правила или исправления старых сведений. если появились — обновить соответствующую запись. если ничего полезного не изменилось — ничего записывать не нужно.
и важно понимать, что речь вообще НЕ идёт о пересказе диалога (если конечно вы не захотите поменять всё под какой-то иной формат логики). тем не менее, лично мне не нужна история всего происходящего — мне нужно, чтобы нейросеть сохранила исключительно важные для работы/контекста/понимания сведения, которые пригодятся в будущем и которые следует помнить или которым следует подчиняться.
Поскольку память ведёт сама нейросеть, важно было сделать так, чтобы она не могла случайно сломать уже сохранённые сведения. поэтому все изменения проходят через черновики: сначала агент подготавливает правку, проверяет её через diff и только после этого сохраняет через push. При этом бюро самостоятельно проверяет структуру данных, корректность связей и актуальность записей. если за время подготовки черновика кто-то уже успел изменить те же сведения, конфликтующая правка будет отклонена. Кроме того, предусмотрена система резервного копирования, которая работает как перед внесением изменений, так и автоматически по расписанию.
В качестве БД используется SQLite. хранить её можно локально на своём устройстве, а можно организовать общую память на сервере, чтобы несколько устройств работали с одной базой. для этого в buro уже предусмотрен серверный режим, который можно настроить из коробки.
установка ручками (рекомендую конечно же агентом, но кому как удобно)
требуется Node.js 24.14+. установка последней опубликованной версии:
npm install -g https://github.com/Krablante/buro/releases/download/v3.0.2/buro-3.0.2.tgz

buro init

buro connect opencodez
последняя команда автоматически устанавливает skill и плагин начального контекста. после этого нужно перезапустить opencodez и, желательно, добавить упомянутый выше блок в системный промпт вручную (перезапуск после добавления не требуется). Сама команда buro connect системный промпт НЕ переписывает.
для остальных харнессов принцип тот же:
buro connect opencode
buro connect codex
buro connect claude
в Codex и Claude начальный контекст подключается через SessionStart hooks, которые при необходимости нужно разрешить в самом харнессе. skill устанавливается той же командой.
Кроме того, существует команда buro update, которая самостоятельно находит и устанавливает последний стабильный релиз с GitHub, обновляет коробочные типы, skills, плагины и hooks. при этом собственные типы и записи сохраняются.
оговорка: что не включено в реализацию и концепцию
В первую очередь я создавал бюро под тех разработчиков, которым нужны четкость, понятность и предсказуемость межсессионной памяти. НЕ ставилась задача создать универсальную память обо всём-всём-всём, которая будет помнить биографию юзера, каждый разговор и все когда-либо произнесённые им слова. создание подобного это совершенно другой вопрос, который можно решать отдельной программой или, конечно же, улучшением самого бюро. Лично у меня такой потребности нет, потому что значительная часть моих предпочтений и универсальных правил работы с нейросетями уже существует в виде сниппетов, которыми я управляю через SnippetDeck (очевидно мультиплатформенный).
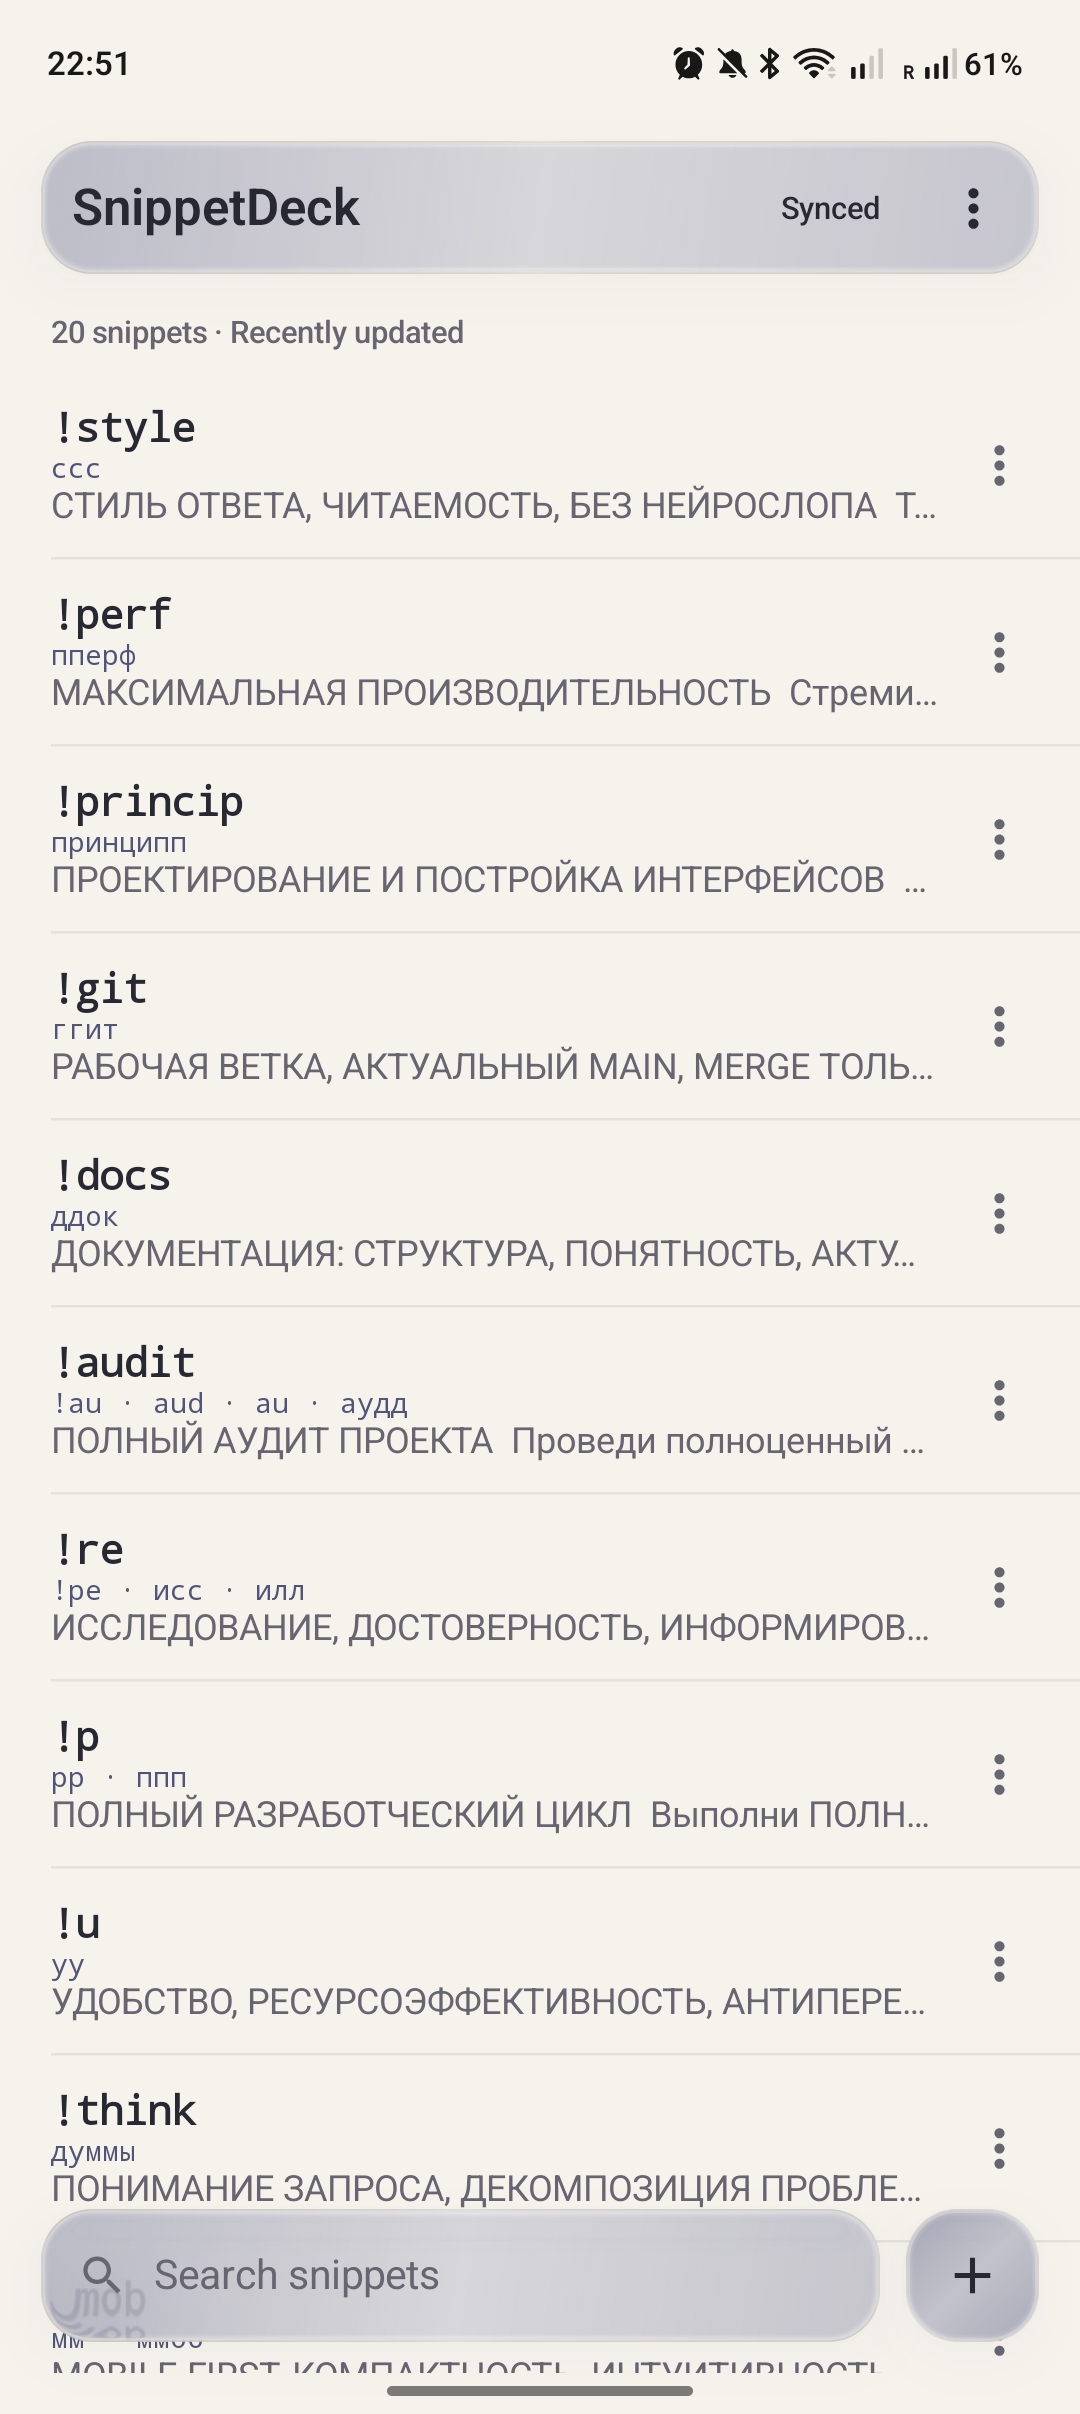
То есть логика работы получается довольно простая: сниппеты определяют то, КАК нейросеть работает и как взаимодействует со мной, а buro предоставляет сведения о том, С ЧЕМ происходит работа и какие с этим связаны правила и важные сведения. У меня не было времени затрахаться и создать систему памяти и учета, которая решит вопрос ПОЛНОЙ памяти о самом юзере, но как это сделать таким образом, чтобы не перевращать подобный автоматический учет во вторую работу — пока не придумал.
При этом я вполне понимаю, что возможности типизированной памяти намного шире, чем наличная реализация. ибо типизировать, учитывать и структурировать можно что угодно. это же относится к продумыванию правил сбора, переваривания и структурирования. НО из-за отсутствия нужды в чем-то мега-гига-универсальном для совсем всех я сделал именно такую систему памяти, какую сделал.
Я попытался сделать buro предельно простым для использования, расширения и переделки. в принципе можно вообще послать мою реализацию нахуй и сделать более крутую репрезентацию концепции типизированной памяти. НО в таком случае всем желающим важно понимать вот что: всегда учитывайте не только bureau но и κράτος, ибо данная типизированная память предполагает то, что её кто-то будет вести (в моем случае нейронка). Это важно, конечно же, если цель именно в автоматизации, а не ручном управлении.
Кроме того, нам мало придумать типы сущностей и поля внутри них. нужно ещё обеспечить логику определения того, какие сущности вообще стоит создавать, какие сведения записывать, когда их пересматривать, как обнаруживать устаревшие данные, противоречия и проч. и всё это должно выполняться, чтобы юзеру не приходилось отдельно заниматься обслуживанием памяти.
поэтому это можно сформулировать так: нужна автономность всей системы, начиная от определения того, что нужно запомнить, и заканчивая поддержанием актуального и согласованного состояния памяти.
buro уже предоставляет структуру, инструменты и инструкции для значительной части этого процесса, но я бы не стал утверждать, что проблема автономности решена полностью в смысле какой-то бесконечной надежности, потому что органом власти всё равно остается ИИ. т.е. качество ведения памяти всё равно зависит от того, насколько хорошо сам агент способен выбирать, проверять и интерпретировать сведения. НО именно поэтому наибольшая смысловая нагрузка всей системы идет именно на pre-этап, а не на остальные её части, ибо именно pre- определяет бОльшую часть будущего качества.
пдф где описано всё устройство и более детально описаны все процессы: https://github.com/Krablante/buro/blob/master/docs/guide.ru.pdf